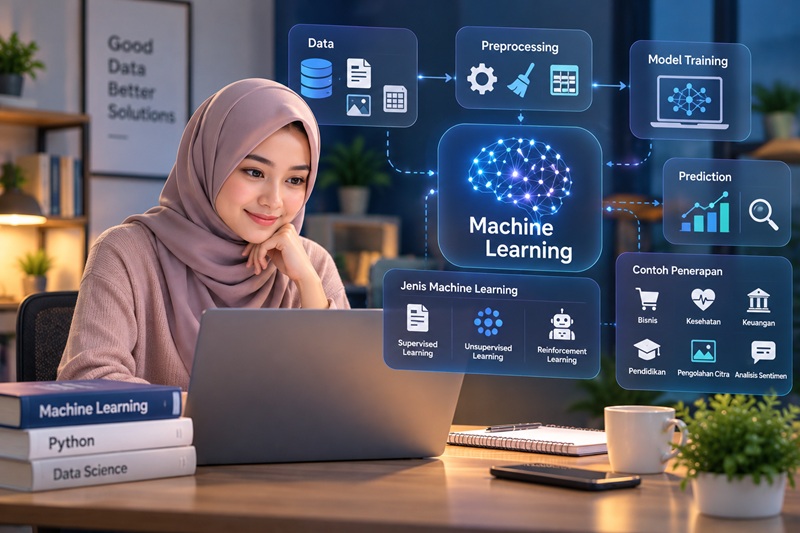
Dalam dunia Machine Learning, ada banyak algoritma yang bisa digunakan untuk mengolah data dan membuat prediksi. Salah satunya adalah XGBoost.
Algoritma ini cukup populer karena mampu menghasilkan model prediksi yang baik untuk berbagai jenis data tabular, seperti data transaksi, data pelanggan, hingga data penjualan.
Lalu, apa itu XGBoost, bagaimana cara kerjanya, dan kapan metode ini cocok digunakan? Mari kita bahas dengan bahasa yang sederhana.
Apa Itu XGBoost?
XGBoost adalah singkatan dari Extreme Gradient Boosting, yaitu algoritma Machine Learning yang menggunakan teknik gradient boosting berbasis pohon keputusan (decision tree).
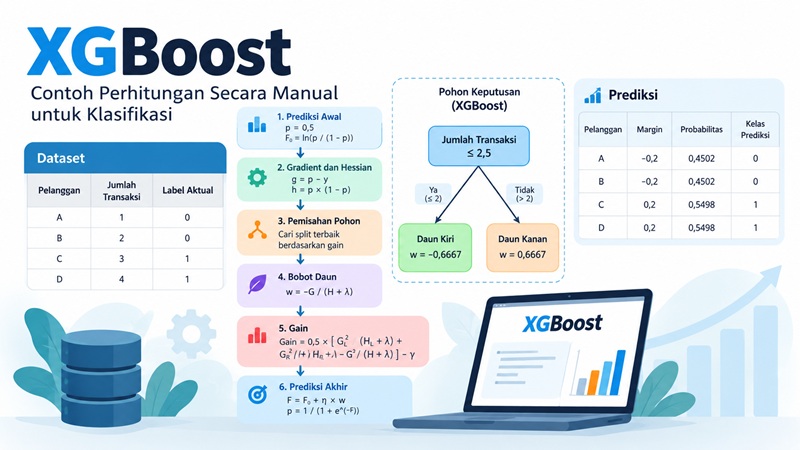
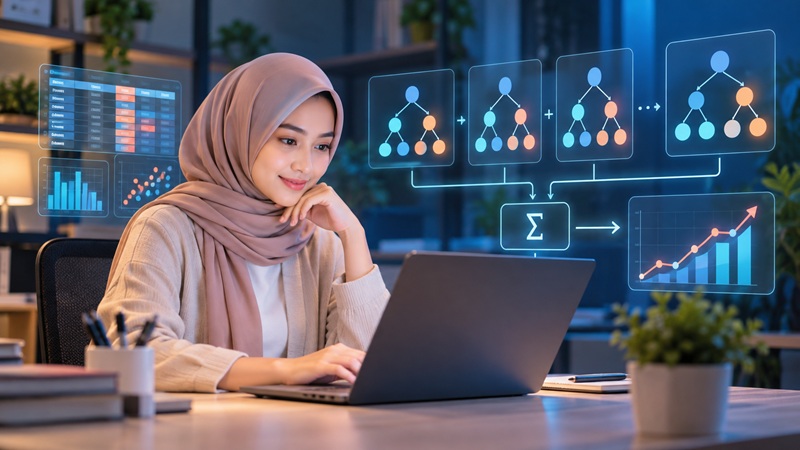
Sederhananya, XGBoost membangun beberapa pohon keputusan secara bertahap. Setiap pohon baru berusaha memperbaiki kesalahan prediksi dari model yang sudah dibuat sebelumnya.
Dengan pendekatan tersebut, gabungan banyak pohon dapat menghasilkan model yang lebih kuat dibandingkan hanya menggunakan satu pohon keputusan.
XGBoost diperkenalkan secara luas melalui penelitian Tianqi Chen dan Carlos Guestrin berjudul XGBoost: A Scalable Tree Boosting System yang dipublikasikan pada konferensi KDD tahun 2016. Penelitian tersebut membahas bagaimana sistem boosting dapat dibuat lebih efisien dan mampu menangani data berukuran besar.
Bagaimana Cara Kerja XGBoost?
Secara umum, cara kerja XGBoost dapat dipahami melalui beberapa tahapan berikut.
1. Menyiapkan data
Data dikumpulkan dan dipersiapkan sebelum digunakan untuk melatih model. Tahap ini dapat mencakup pembersihan data, penanganan nilai kosong, serta pemilihan fitur yang relevan.
2. Membuat pohon keputusan pertama
Model mulai mempelajari pola dari data menggunakan pohon keputusan. Hasil prediksi awal ini belum tentu akurat.
3. Memperbaiki kesalahan prediksi
XGBoost menghitung kesalahan model menggunakan fungsi objektif dan informasi gradien. Hasilnya digunakan untuk membangun pohon berikutnya agar prediksi menjadi lebih baik.
4. Menggabungkan hasil setiap pohon
Proses penambahan pohon dilakukan secara bertahap. Prediksi akhir merupakan hasil gabungan kontribusi dari pohon-pohon yang telah dibangun.
5. Melakukan evaluasi
Model diuji menggunakan data yang tidak digunakan untuk pelatihan. Hasilnya kemudian dievaluasi menggunakan metrik yang sesuai dengan tujuan penelitian.
Dengan proses tersebut, XGBoost berusaha menghasilkan prediksi yang akurat sekaligus mengendalikan kompleksitas model agar tidak terlalu menyesuaikan diri dengan data pelatihan.
Apa Saja Fungsi XGBoost dalam Machine Learning?
XGBoost dapat digunakan untuk berbagai kebutuhan pengolahan data. Dua tugas yang paling umum adalah klasifikasi dan regresi.
1. Klasifikasi
Klasifikasi digunakan untuk memprediksi kategori atau kelas dari suatu data.
Contohnya:
- Mendeteksi transaksi yang berpotensi fraud atau normal.
- Memprediksi pelanggan yang berpotensi berhenti berlangganan.
- Mengklasifikasikan kelayakan penerima bantuan.
- Memprediksi apakah pelanggan akan membeli suatu produk.
Pada kasus tersebut, model mempelajari pola dari data historis untuk menentukan kelas yang paling sesuai bagi data baru.
2. Regresi
Regresi digunakan untuk memprediksi nilai numerik.
Contohnya:
- Memprediksi harga rumah.
- Memperkirakan jumlah penjualan.
- Memprediksi permintaan produk.
- Memperkirakan biaya berdasarkan karakteristik tertentu.
Meskipun sama-sama menggunakan XGBoost, konfigurasi model dan metrik evaluasi untuk klasifikasi dan regresi perlu disesuaikan dengan tujuan masing-masing.
Apa Kelebihan XGBoost?
XGBoost memiliki beberapa kelebihan yang membuatnya banyak digunakan dalam proyek Machine Learning.
1. Performa prediksi yang baik
Teknik boosting memungkinkan model mempelajari pola data secara bertahap. Pada banyak permasalahan data tabular, XGBoost dapat menjadi salah satu algoritma yang layak diuji.
2. Mendukung berbagai jenis tugas
XGBoost dapat digunakan untuk klasifikasi, regresi, dan sejumlah tugas lain seperti learning to rank.
3. Memiliki regularisasi
XGBoost menyediakan mekanisme regularisasi untuk membantu mengendalikan kompleksitas model dan mengurangi risiko overfitting.
4. Mendukung pengaturan parameter
Pengguna dapat mengatur parameter seperti jumlah pohon, kedalaman pohon, dan learning rate untuk menyesuaikan proses pelatihan.
5. Mendukung analisis kepentingan fitur
Model dapat digunakan untuk melihat fitur yang berkontribusi terhadap prediksi. Namun, informasi tersebut tidak otomatis menjelaskan hubungan sebab-akibat atau alasan setiap prediksi secara lengkap.
Apa Kekurangan XGBoost?
Walaupun memiliki banyak kelebihan, XGBoost juga mempunyai beberapa keterbatasan.
- Membutuhkan pengaturan parameter. Parameter yang kurang sesuai dapat membuat model terlalu sederhana atau mengalami overfitting.
- Memerlukan persiapan data. Data yang tidak berkualitas dapat memengaruhi hasil prediksi.
- Tidak selalu menjadi algoritma terbaik. Kinerjanya bergantung pada karakteristik data dan tujuan penelitian.
- Interpretasinya tidak sesederhana satu pohon keputusan. Model yang terdiri dari banyak pohon lebih sulit dijelaskan secara langsung.
Karena itu, XGBoost sebaiknya dibandingkan dengan algoritma lain yang relevan dan dievaluasi menggunakan metode pengujian yang tepat.
Contoh Penerapan XGBoost untuk Penelitian Skripsi
XGBoost dapat digunakan dalam berbagai penelitian mahasiswa, terutama yang berhubungan dengan klasifikasi data dan prediksi berbasis data historis.
Misalnya, penelitian tentang deteksi transaksi keuangan mencurigakan. Dataset berisi informasi transaksi yang telah diberi label normal atau fraud dapat digunakan untuk melatih model klasifikasi.
Alur penelitian secara sederhana adalah:
- Mengumpulkan dataset yang relevan.
- Melakukan pembersihan dan preprocessing data.
- Membagi data menjadi data latih dan data uji.
- Melatih model menggunakan XGBoost.
- Menguji hasil prediksi menggunakan data uji.
- Mengevaluasi performa menggunakan confusion matrix, accuracy, precision, recall, dan F1-score.
Untuk kasus deteksi fraud, accuracy saja belum tentu cukup. Jika jumlah transaksi normal jauh lebih banyak daripada transaksi fraud, model dapat terlihat akurat meskipun gagal mendeteksi banyak transaksi fraud. Oleh sebab itu, precision, recall, F1-score, dan metrik lain yang sesuai perlu dipertimbangkan.
Contoh tersebut juga dapat dikembangkan menjadi penelitian dengan membandingkan XGBoost terhadap algoritma lain, seperti Random Forest atau Support Vector Machine (SVM).
Kesimpulan
XGBoost adalah algoritma Machine Learning berbasis gradient boosting yang menggabungkan banyak pohon keputusan untuk menghasilkan prediksi. Algoritma ini dapat digunakan untuk klasifikasi maupun regresi dan menawarkan berbagai fitur untuk meningkatkan efisiensi serta mengendalikan kompleksitas model.
Namun, hasil yang baik tetap bergantung pada kualitas dataset, pemilihan parameter, dan metode evaluasi yang digunakan.
Bagi mahasiswa yang sedang mengerjakan skripsi atau tugas akhir di bidang Machine Learning, XGBoost bisa menjadi salah satu metode yang menarik untuk dipelajari dan diuji sesuai dengan permasalahan penelitian.
Ingin Mencoba Metode XGBoost dalam Program?
Bagi Anda yang ingin mempelajari penerapan XGBoost secara langsung, Anda juga bisa melihat Aplikasi Machine Learning XGBoost untuk mencoba proses klasifikasi data melalui aplikasi berbasis web.
Lihat Source Code XGBoostReferensi
Chen, T., & Guestrin, C. (2016). XGBoost: A Scalable Tree Boosting System. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 785–794.
DOI: https://doi.org/10.1145/2939672.2939785
Dokumentasi resmi: https://xgboost.readthedocs.io/en/stable/