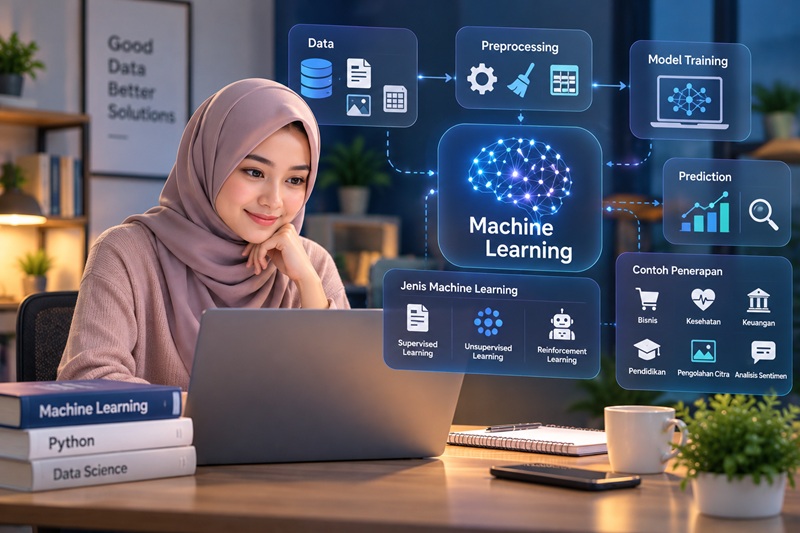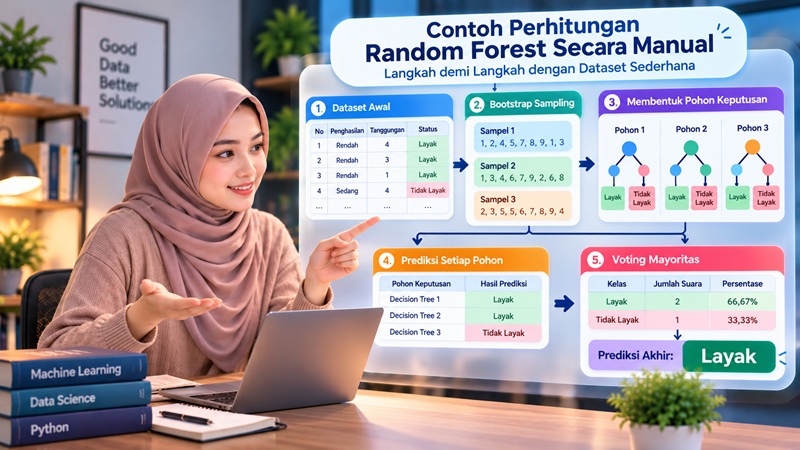
Random Forest merupakan salah satu algoritma Machine Learning yang sering digunakan untuk menyelesaikan permasalahan klasifikasi dan prediksi. Algoritma ini menggabungkan beberapa pohon keputusan (Decision Tree) untuk menghasilkan prediksi akhir yang lebih stabil.
Meskipun cukup populer dalam penelitian, banyak mahasiswa yang masih kesulitan memahami cara kerja Random Forest karena prosesnya melibatkan pengambilan sampel data secara acak, pembentukan pohon keputusan, pemilihan fitur, dan penggabungan hasil prediksi.
Pada artikel ini, kita akan membahas contoh perhitungan Random Forest secara manual menggunakan dataset sederhana. Contoh yang digunakan berfokus pada klasifikasi kelayakan bantuan agar setiap tahapan lebih mudah dipahami.
1. Menyiapkan Dataset Random Forest
Langkah pertama adalah menyiapkan dataset yang akan digunakan untuk melatih model. Dataset harus memiliki sejumlah fitur sebagai variabel input dan satu kolom target sebagai kelas yang ingin diprediksi.
Misalnya, kita ingin membuat sistem klasifikasi sederhana untuk memperkirakan kelayakan penerima bantuan berdasarkan penghasilan dan jumlah tanggungan keluarga.
Berikut contoh dataset yang digunakan.
| No. | Penghasilan | Tanggungan | Status |
|---|---|---|---|
| 1 | Rendah | 4 | Layak |
| 2 | Rendah | 3 | Layak |
| 3 | Rendah | 1 | Layak |
| 4 | Sedang | 4 | Layak |
| 5 | Sedang | 2 | Tidak Layak |
| 6 | Sedang | 1 | Tidak Layak |
| 7 | Tinggi | 3 | Tidak Layak |
| 8 | Tinggi | 2 | Tidak Layak |
| 9 | Tinggi | 1 | Tidak Layak |
Keterangan:
- Penghasilan merupakan fitur pertama yang digunakan dalam klasifikasi.
- Tanggungan merupakan fitur kedua yang menggambarkan jumlah anggota keluarga yang menjadi tanggungan.
- Status merupakan variabel target yang terdiri dari kelas Layak dan Tidak Layak.
Dataset tersebut hanya contoh untuk pembelajaran, bukan standar resmi penentuan penerima bantuan. Dari sembilan data tersebut, terdapat empat data berstatus Layak dan lima data berstatus Tidak Layak.
Tujuan kita adalah membangun model Random Forest yang dapat memprediksi status untuk data baru berdasarkan pola yang dipelajari dari data pelatihan.
2. Memahami Proses Bootstrap Sampling
Random Forest tidak hanya membangun satu pohon keputusan. Algoritma ini membangun banyak pohon menggunakan variasi sampel data.
Salah satu proses yang digunakan adalah bootstrap sampling, yaitu mengambil sampel dari dataset dengan pengembalian (sampling with replacement).
Artinya, sebuah data dapat terpilih lebih dari satu kali dalam satu sampel, sementara data lainnya mungkin tidak terpilih. Sebagai ilustrasi, kita dapat membentuk tiga sampel bootstrap dari dataset sebelumnya.
| Sampel | Contoh nomor data yang terambil |
|---|---|
| Sampel 1 | 1, 2, 4, 5, 7, 8, 9, 1, 3 |
| Sampel 2 | 1, 3, 4, 6, 7, 9, 2, 6, 8 |
| Sampel 3 | 2, 3, 5, 5, 6, 7, 8, 9, 4 |
Pada Sampel 1, misalnya, data nomor 1 terambil dua kali, sedangkan data nomor 6 tidak terambil. Sampel tersebut kemudian digunakan untuk membangun pohon keputusan yang berbeda.
Catatan: tabel bootstrap di atas merupakan ilustrasi pengambilan sampel. Untuk eksperimen nyata, sampel biasanya dihasilkan secara acak oleh algoritma, bukan dipilih dengan pola yang sudah ditentukan.
3. Membentuk Pohon Keputusan
Setelah bootstrap sampling, setiap sampel digunakan untuk membangun pohon keputusan.
Dalam Random Forest, pemilihan fitur untuk menentukan pemisahan data juga melibatkan unsur acak. Pada setiap simpul, algoritma mempertimbangkan sebagian fitur, kemudian memilih pemisahan terbaik dari fitur yang tersedia berdasarkan kriteria tertentu.
Salah satu kriteria yang dapat digunakan untuk klasifikasi adalah Gini impurity.
Rumus Gini impurity adalah:
Gini = 1 − Σ(pᵢ²)
Keterangan:
- pᵢ adalah proporsi data dari kelas ke-i pada suatu simpul.
- Nilai Gini menunjukkan tingkat campuran kelas dalam simpul.
- Nilai Gini sebesar 0 menunjukkan bahwa seluruh data dalam simpul berasal dari kelas yang sama.
Contoh menghitung Gini impurity
Pada dataset awal, terdapat empat data Layak dan lima data Tidak Layak.
Proporsi kelas Layak:
p₁ = 4/9
Proporsi kelas Tidak Layak:
p₂ = 5/9
Maka nilai Gini impurity dataset awal adalah:
Gini = 1 − (4/9)² − (5/9)²
Gini = 1 − 16/81 − 25/81
Gini = 40/81 ≈ 0,494
Nilai tersebut menunjukkan bahwa dataset masih terdiri dari dua kelas yang bercampur.
Selanjutnya, algoritma dapat mengevaluasi beberapa kandidat pemisahan fitur untuk menentukan pemisahan yang paling baik. Dalam implementasi Random Forest, proses ini dilakukan secara berulang pada simpul-simpul pohon.
Pohon-pohon yang dihasilkan dapat memiliki struktur berbeda karena sampel data dan fitur yang dipertimbangkan tidak selalu sama.
4. Menghasilkan Prediksi dari Setiap Pohon
Setelah pohon keputusan selesai dibentuk, setiap pohon dapat digunakan untuk memprediksi data baru.
Misalnya, terdapat calon penerima bantuan dengan karakteristik berikut:
| Fitur | Nilai |
|---|---|
| Penghasilan | Sedang |
| Tanggungan | 3 |
Data ini belum memiliki label status. Kita ingin mengetahui apakah model mengklasifikasikannya sebagai Layak atau Tidak Layak.
Untuk menyederhanakan penjelasan, anggap kita sudah memiliki tiga pohon keputusan hasil pelatihan. Ketika data baru dimasukkan, masing-masing pohon memberikan prediksi berikut.
| Pohon keputusan | Hasil prediksi |
|---|---|
| Decision Tree 1 | Layak |
| Decision Tree 2 | Layak |
| Decision Tree 3 | Tidak Layak |
Perhatikan bahwa setiap pohon dapat menghasilkan prediksi yang berbeda. Inilah alasan Random Forest menggabungkan hasil dari banyak pohon, alih-alih hanya mengandalkan satu pohon keputusan.
Tabel ini merupakan ilustrasi hasil prediksi pohon yang telah dilatih, bukan hasil pembentukan pohon yang dihitung secara lengkap dari dataset sebelumnya.
5. Menghitung Voting Mayoritas
Pada tugas klasifikasi, Random Forest dapat menentukan kelas akhir berdasarkan suara terbanyak dari pohon-pohon keputusan.
Berdasarkan hasil sebelumnya:
- Prediksi Layak: 2 suara.
- Prediksi Tidak Layak: 1 suara.
- Total pohon: 3.
Proporsi suara untuk kelas Layak:
2/3 × 100% = 66,67%
Proporsi suara untuk kelas Tidak Layak:
1/3 × 100% = 33,33%
Tabel hasil voting:
| Kelas | Jumlah suara | Persentase suara |
|---|---|---|
| Layak | 2 | 66,67% |
| Tidak Layak | 1 | 33,33% |
| Total | 3 | 100% |
Karena kelas Layak memperoleh suara terbanyak, prediksi akhir Random Forest untuk contoh tersebut adalah Layak.
Perhitungan ini menggambarkan prinsip voting mayoritas. Persentase suara tersebut tidak otomatis sama dengan probabilitas bahwa seseorang benar-benar layak menerima bantuan.
6. Bagaimana Jika Jumlah Pohon Lebih Banyak?
Dalam implementasi nyata, Random Forest biasanya menggunakan lebih banyak pohon daripada tiga pohon dalam ilustrasi sebelumnya.
Misalnya, model menggunakan 100 pohon keputusan dan menghasilkan hasil voting berikut:
| Kelas | Jumlah suara | Persentase suara |
|---|---|---|
| Layak | 72 | 72% |
| Tidak Layak | 28 | 28% |
| Total | 100 | 100% |
Berdasarkan voting mayoritas, prediksi akhir adalah Layak.
Contoh ini menunjukkan bagaimana hasil dari banyak pohon dapat digabungkan. Angka 72 dan 28 merupakan ilustrasi, bukan hasil eksperimen dari dataset sebelumnya.
Menambah jumlah pohon tidak selalu membuat model lebih akurat pada setiap dataset, tetapi dapat membantu menstabilkan prediksi hingga manfaat penambahan pohon semakin kecil. Jumlah pohon yang sesuai sebaiknya ditentukan melalui pengujian.
7. Bagaimana Jika Random Forest Digunakan untuk Regresi?
Selain klasifikasi, Random Forest juga dapat digunakan untuk memprediksi nilai numerik melalui Random Forest Regression.
Pada regresi, hasil prediksi dari pohon-pohon biasanya digabungkan menggunakan rata-rata. Misalnya, tiga pohon memberikan prediksi harga rumah sebagai berikut:
| Pohon keputusan | Prediksi harga |
|---|---|
| Decision Tree 1 | Rp300.000.000 |
| Decision Tree 2 | Rp320.000.000 |
| Decision Tree 3 | Rp310.000.000 |
Rata-rata prediksi dihitung dengan rumus:
Rata-rata = jumlah seluruh prediksi / jumlah pohon
Rata-rata = (300.000.000 + 320.000.000 + 310.000.000) / 3
Rata-rata = Rp310.000.000
Dengan demikian, prediksi akhir Random Forest Regression pada contoh tersebut adalah Rp310.000.000. Perbedaan utamanya adalah klasifikasi menggabungkan prediksi kelas, sedangkan regresi umumnya menggabungkan nilai numerik.
8. Apakah Perhitungan Manual Ini Sama dengan Random Forest Sebenarnya?
Contoh sebelumnya menjelaskan sebagian mekanisme Random Forest, terutama bootstrap sampling, konsep Gini impurity, dan penggabungan hasil prediksi.
Namun, contoh tersebut belum merupakan perhitungan lengkap pembentukan Random Forest dari awal hingga akhir. Untuk mereproduksi hasil model secara penuh, kita perlu menentukan sampel bootstrap, fitur yang dipertimbangkan pada setiap simpul, aturan pemisahan terbaik, kondisi penghentian pertumbuhan pohon, serta hasil prediksi setiap pohon yang benar-benar terbentuk.
Dalam penelitian atau pengembangan aplikasi, proses tersebut biasanya dikerjakan menggunakan library Machine Learning seperti Scikit-learn pada Python.
Perhitungan manual tetap berguna untuk memahami prinsip algoritma. Sementara itu, implementasi menggunakan perangkat lunak lebih praktis ketika dataset berukuran besar atau memiliki banyak fitur.
Baca juga apa itu Apa Itu Random Forest? Pengertian, Cara Kerja, dan Contoh Penerapannya
Kesimpulan
Random Forest merupakan algoritma Machine Learning yang menggabungkan banyak pohon keputusan untuk menghasilkan prediksi. Dalam klasifikasi, hasil prediksi dapat ditentukan melalui voting mayoritas, sedangkan dalam regresi hasilnya umumnya digabungkan dengan menghitung rata-rata.
Berdasarkan contoh perhitungan manual, kita dapat memahami beberapa tahapan utama, mulai dari menyiapkan dataset, memahami bootstrap sampling, mengenal Gini impurity, hingga menghitung hasil voting.
Bagi mahasiswa yang sedang menyusun penelitian, pemahaman tersebut dapat menjadi dasar sebelum menerapkan Random Forest pada dataset yang lebih besar.
Setelah memahami konsep manualnya, langkah berikutnya adalah mencoba membangun model menggunakan Python, membagi data menjadi data pelatihan dan pengujian, lalu mengevaluasi performanya dengan metrik yang sesuai dengan tujuan penelitian.
Ingin Mencoba Random Forest Full PHP & MySQL?
Bagi Anda yang ingin mempelajari penerapan Random Forest berbasis web Full PHP, Anda juga bisa melihat Aplikasi Machine Learning Random Forest Klasifikasi untuk mencoba proses klasifikasi data melalui aplikasi berbasis web.
Lihat Source Code Random ForestSumber Referensi
Artikel ini disusun dengan mengacu pada dokumentasi resmi Scikit-learn mengenai Random Forest dan Decision Tree, yang menjelaskan konsep pembentukan pohon keputusan, pemilihan fitur, serta proses klasifikasi dan prediksi. Referensi tambahan berasal dari penelitian Leo Breiman berjudul Random Forests, yang diterbitkan dalam jurnal Machine Learning pada tahun 2001. Contoh dataset, angka perhitungan, dan ilustrasi voting dalam artikel ini disusun secara sederhana untuk tujuan pembelajaran agar pembaca lebih mudah memahami prinsip kerja algoritma Random Forest secara manual.