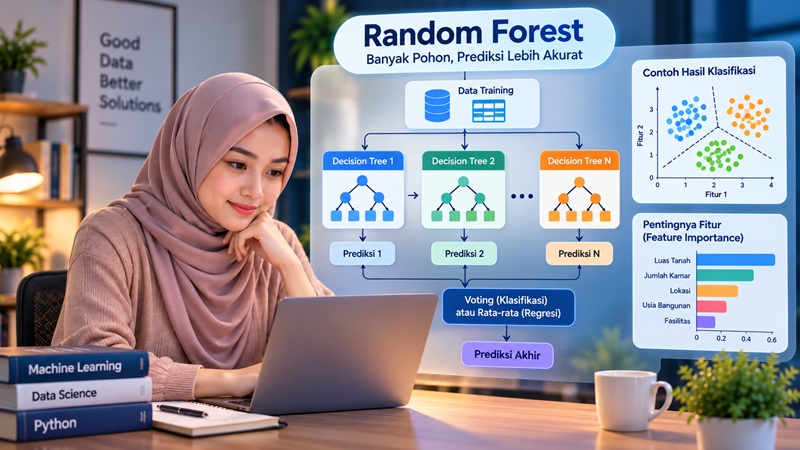
Dalam Machine Learning, pemilihan algoritma yang tepat dapat memengaruhi hasil prediksi sebuah sistem. Salah satu algoritma yang cukup populer untuk mengolah data dan membuat prediksi adalah Random Forest.
Algoritma ini banyak digunakan untuk berbagai kebutuhan, seperti klasifikasi sentimen pelanggan, deteksi penipuan transaksi, prediksi harga, hingga analisis data penelitian.
Keunggulan Random Forest terletak pada kemampuannya menggabungkan hasil dari banyak pohon keputusan (Decision Tree) sehingga menghasilkan prediksi yang lebih stabil dibandingkan mengandalkan satu pohon saja dalam banyak kasus.
Lalu, apa itu Random Forest, bagaimana cara kerjanya, dan kapan metode ini sebaiknya digunakan? Simak penjelasan berikut.
Apa Itu Random Forest?
Random Forest adalah algoritma Machine Learning berbasis ensemble learning yang menggabungkan banyak pohon keputusan untuk menghasilkan prediksi.
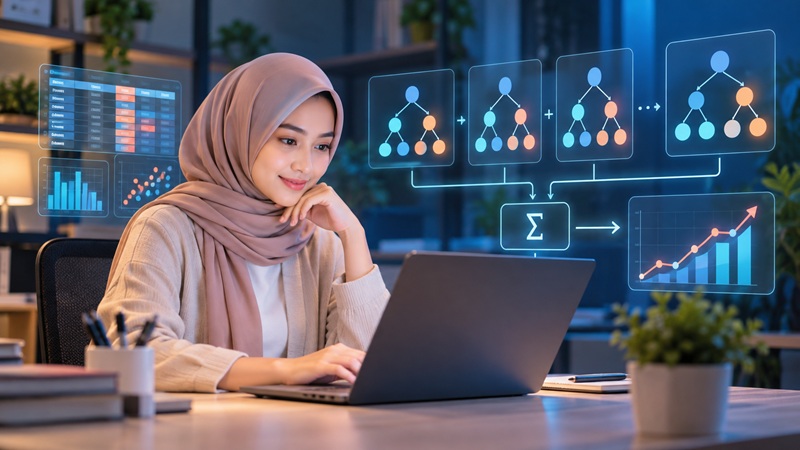
Sederhananya, algoritma ini bekerja seperti sekumpulan pengambil keputusan. Setiap pohon keputusan mempelajari pola dari data dan menghasilkan prediksi sendiri. Selanjutnya, hasil dari seluruh pohon digabungkan untuk menentukan prediksi akhir.
Random Forest dapat digunakan untuk dua jenis permasalahan utama, yaitu:
- Klasifikasi: memprediksi kategori atau kelas, misalnya transaksi penipuan atau bukan penipuan.
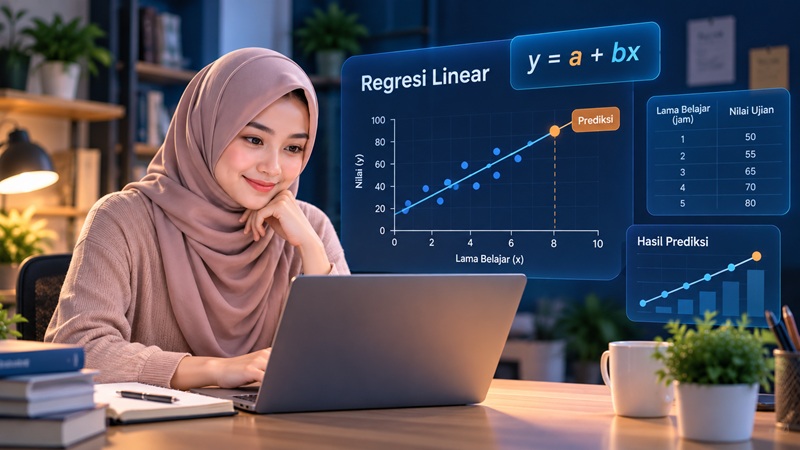
- Regresi: memprediksi nilai numerik, misalnya harga rumah atau jumlah penjualan.
Pendekatan ini dikembangkan dari konsep pohon keputusan dengan memanfaatkan pengambilan sampel data secara acak dan pemilihan fitur secara acak pada proses pembentukan pohon.
Dengan menggabungkan banyak pohon yang memiliki variasi, Random Forest dapat membantu mengurangi risiko model terlalu menyesuaikan diri terhadap data pelatihan (overfitting) dibandingkan penggunaan satu pohon keputusan yang kompleks.
Bagaimana Cara Kerja Random Forest?
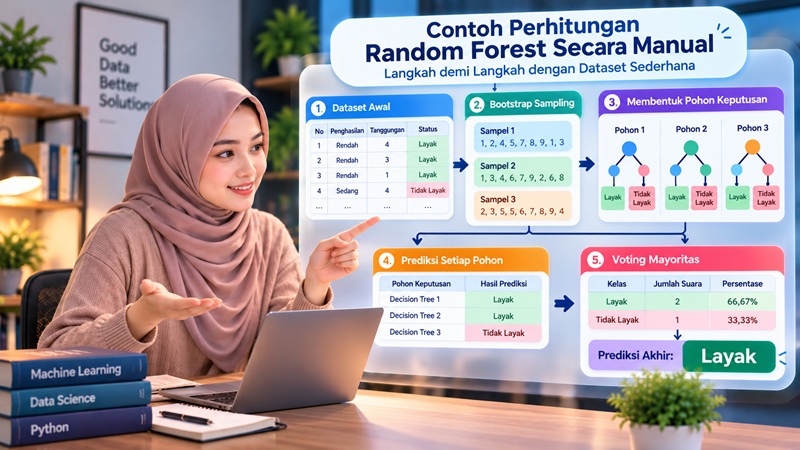
Secara umum, Random Forest bekerja melalui beberapa tahapan. Berikut penjelasannya.
1. Mengambil Sampel Data Secara Acak
Algoritma mengambil sampel dari data pelatihan menggunakan teknik bootstrap sampling. Dalam pendekatan ini, sampel biasanya diambil dengan pengembalian sehingga beberapa data bisa terpilih lebih dari satu kali, sedangkan data lain mungkin tidak terpilih.
Sampel yang berbeda membantu menghasilkan pohon keputusan yang bervariasi.
2. Membentuk Banyak Pohon Keputusan
Setiap sampel digunakan untuk membangun pohon keputusan. Saat pohon menentukan pemisahan data pada suatu simpul, algoritma hanya mempertimbangkan sebagian fitur yang dipilih secara acak, kemudian menentukan pemisahan terbaik di antara fitur yang tersedia tersebut.
Proses ini membedakan Random Forest dari sekumpulan pohon keputusan biasa yang dibangun dengan cara identik.
3. Menghasilkan Prediksi dari Setiap Pohon
Setelah proses pelatihan selesai, setiap pohon akan memberikan prediksi ketika menerima data baru.
Sebagai contoh, pada klasifikasi transaksi, sebagian pohon mungkin memprediksi transaksi sebagai penipuan, sedangkan pohon lainnya memprediksi transaksi tersebut sebagai transaksi normal.
4. Menggabungkan Hasil Prediksi
Tahap terakhir adalah menggabungkan hasil prediksi seluruh pohon.
- Untuk klasifikasi, prediksi dapat ditentukan berdasarkan suara terbanyak (majority voting) atau agregasi probabilitas kelas.
- Untuk regresi, prediksi umumnya diperoleh dengan menghitung rata-rata prediksi dari seluruh pohon.
Dengan pendekatan tersebut, keputusan akhir tidak hanya bergantung pada satu pohon keputusan.
Contoh Penerapan Random Forest
Random Forest dapat digunakan untuk berbagai kebutuhan di dunia nyata maupun penelitian akademik.
1. Klasifikasi Sentimen
Random Forest dapat digunakan untuk mengklasifikasikan ulasan pelanggan ke dalam kategori sentimen positif, negatif, atau netral.
Sebelum digunakan, teks perlu diubah menjadi representasi numerik yang dapat diproses oleh model. Contohnya, fitur teks dapat dibentuk menggunakan metode TF-IDF.
Model kemudian dilatih menggunakan data ulasan yang sudah memiliki label sentimen. Setelah pelatihan, model dapat digunakan untuk memprediksi sentimen ulasan baru.
2. Deteksi Penipuan Transaksi
Dalam bidang keuangan, Random Forest dapat membantu mengklasifikasikan transaksi berdasarkan pola yang ditemukan pada data historis.
Fitur yang digunakan dapat mencakup nilai transaksi, waktu transaksi, frekuensi transaksi, dan karakteristik lainnya yang relevan.
Namun, deteksi penipuan sering menghadapi masalah ketidakseimbangan kelas karena transaksi penipuan biasanya jauh lebih sedikit daripada transaksi normal. Oleh sebab itu, evaluasi tidak sebaiknya hanya mengandalkan akurasi, tetapi juga mempertimbangkan precision, recall, dan F1-score.
3. Prediksi Harga Rumah
Random Forest Regression dapat digunakan untuk memperkirakan harga rumah berdasarkan sejumlah karakteristik, seperti luas bangunan, luas tanah, jumlah kamar, dan lokasi.
Model mempelajari pola dari data rumah yang telah diketahui harganya. Setelah dilatih, model dapat memberikan estimasi harga untuk rumah dengan karakteristik baru.
4. Klasifikasi Data Mahasiswa
Dalam penelitian pendidikan, Random Forest dapat digunakan untuk memprediksi kategori tertentu berdasarkan data yang relevan, misalnya klasifikasi risiko keterlambatan kelulusan.
Penggunaannya harus mempertimbangkan kualitas data, privasi, potensi bias, dan dampak keputusan terhadap mahasiswa. Prediksi model sebaiknya digunakan sebagai alat bantu analisis, bukan sebagai satu-satunya dasar pengambilan keputusan.
5. Analisis Data Kesehatan dan Lingkungan
Random Forest juga dapat digunakan untuk mengklasifikasikan data kesehatan, membantu analisis faktor risiko, atau memprediksi kategori kondisi lingkungan berdasarkan data pengamatan.
Sebagai contoh, algoritma ini pernah digunakan dalam penelitian klasifikasi curah hujan di Daerah Istimewa Yogyakarta dan dibandingkan dengan Support Vector Machine (SVM). Hasil penelitian tersebut menunjukkan bahwa performa algoritma dapat berbeda tergantung pada data dan pengaturan model yang digunakan.
Kelebihan Random Forest
Random Forest memiliki beberapa kelebihan yang membuatnya sering dipilih untuk menyelesaikan permasalahan Machine Learning.
1. Dapat digunakan untuk klasifikasi dan regresi
Satu pendekatan algoritma dapat diterapkan untuk memprediksi kategori maupun nilai numerik, dengan model yang disesuaikan terhadap tujuan permasalahan.
2. Mampu menangani hubungan yang kompleks
Random Forest dapat mempelajari hubungan nonlinier dan interaksi antarfitur tanpa harus menentukan persamaan hubungan secara manual.
3. Mengurangi risiko overfitting dibandingkan satu pohon
Penggabungan banyak pohon dapat mengurangi varians prediksi dibandingkan penggunaan satu pohon keputusan yang tidak dibatasi. Meski demikian, Random Forest tetap dapat menghasilkan model yang kurang baik jika data atau pengaturannya tidak sesuai.
4. Menyediakan informasi pentingnya fitur
Random Forest dapat menghasilkan ukuran feature importance untuk membantu mengidentifikasi fitur yang berkontribusi terhadap prediksi model.
Namun, feature importance tidak otomatis menunjukkan hubungan sebab-akibat. Ukuran tertentu juga dapat memiliki bias, sehingga interpretasinya perlu dilakukan dengan hati-hati.
5. Tidak selalu membutuhkan preprocessing yang rumit
Untuk banyak dataset tabular, Random Forest dapat bekerja tanpa normalisasi atau standardisasi fitur numerik. Meski begitu, penanganan data kosong, encoding variabel kategorikal, dan preprocessing lainnya tetap perlu disesuaikan dengan implementasi yang digunakan.
Kekurangan Random Forest
Walaupun memiliki sejumlah kelebihan, Random Forest juga mempunyai keterbatasan.
- Membutuhkan sumber daya komputasi: semakin banyak pohon dan semakin besar dataset, semakin besar pula kebutuhan waktu dan memori.
- Interpretasi lebih sulit: memahami keputusan keseluruhan model umumnya tidak sesederhana membaca satu pohon keputusan.
- Model dapat berukuran besar: penyimpanan dan penggunaan model bisa menjadi pertimbangan pada sistem dengan sumber daya terbatas.
- Tidak selalu menjadi algoritma terbaik: pada dataset tertentu, metode seperti regresi linear, SVM, atau boosting dapat menghasilkan performa yang lebih baik.
- Prediksi regresi memiliki keterbatasan: Random Forest Regression berbasis rata-rata prediksi pohon umumnya tidak mengekstrapolasi tren di luar rentang target yang dipelajari dengan baik.
Karena itu, pemilihan Random Forest sebaiknya didasarkan pada pengujian, bukan hanya popularitas algoritmanya.
Parameter Penting dalam Random Forest
Ketika membangun model Random Forest, ada beberapa parameter yang dapat memengaruhi hasilnya.
| Parameter | Fungsi |
|---|---|
n_estimators |
Menentukan jumlah pohon yang dibangun. |
max_depth |
Membatasi kedalaman maksimum setiap pohon. |
max_features |
Menentukan jumlah atau proporsi fitur yang dipertimbangkan saat mencari pemisahan. |
min_samples_split |
Menentukan jumlah minimum sampel untuk membagi suatu simpul. |
min_samples_leaf |
Menentukan jumlah minimum sampel yang harus ada pada simpul daun. |
Parameter tersebut dapat disesuaikan melalui eksperimen atau proses hyperparameter tuning.
Menambah jumlah pohon dapat membantu menstabilkan hasil, tetapi biasanya juga menambah waktu komputasi. Sementara itu, pembatasan kedalaman pohon dapat membantu mengendalikan kompleksitas model.
Tidak ada kombinasi parameter yang selalu terbaik untuk semua dataset.
Cara Membuat Model Random Forest dengan Python
Salah satu cara mempelajari Random Forest adalah menggunakan Python dan library Scikit-learn. Library ini menyediakan implementasi Random Forest untuk klasifikasi maupun regresi.
Berikut contoh sederhana untuk klasifikasi menggunakan dataset Iris yang tersedia di Scikit-learn.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# Memuat dataset
data = load_iris()
X = data.data
y = data.target

# Membagi data menjadi training dan testing
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

# Membuat model Random Forest
model = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

# Melatih model
model.fit(X_train, y_train)

# Melakukan prediksi
y_pred = model.predict(X_test)

# Mengevaluasi model
akurasi = accuracy_score(y_test, y_pred)
print("Akurasi:", akurasi)
Pada contoh tersebut, dataset Iris dibagi menjadi data pelatihan dan data pengujian. Model dilatih menggunakan 100 pohon keputusan, kemudian digunakan untuk memprediksi kelas pada data pengujian.
Nilai akurasi dihitung dengan membandingkan hasil prediksi dengan label aktual. Angka yang diperoleh dapat berbeda jika dataset, pembagian data, atau parameter model diubah.
Untuk penelitian yang lebih serius, evaluasi sebaiknya juga mempertimbangkan confusion matrix, precision, recall, F1-score, atau metrik lain yang sesuai dengan tujuan klasifikasi.
Perbedaan Random Forest dan Decision Tree
Random Forest dan Decision Tree sama-sama menggunakan struktur pohon keputusan, tetapi memiliki cara menghasilkan prediksi yang berbeda.
| Aspek | Decision Tree | Random Forest |
|---|---|---|
| Struktur model | Satu pohon | Banyak pohon |
| Proses prediksi | Mengikuti satu jalur keputusan | Menggabungkan prediksi banyak pohon |
| Interpretasi | Relatif mudah | Lebih kompleks |
| Risiko overfitting | Dapat tinggi jika pohon terlalu kompleks | Umumnya lebih terkendali melalui agregasi |
| Kebutuhan komputasi | Biasanya lebih ringan | Biasanya lebih besar |
Decision Tree dapat menjadi pilihan ketika kemudahan interpretasi menjadi prioritas. Random Forest dapat menjadi alternatif ketika dibutuhkan prediksi yang lebih stabil dan kemampuan menangani pola data yang beragam.
Perbedaan Random Forest dan XGBoost
Random Forest dan XGBoost sama-sama termasuk metode ensemble learning, tetapi cara membangun modelnya berbeda.
Random Forest umumnya membangun banyak pohon secara relatif independen, kemudian menggabungkan hasilnya. XGBoost membangun model secara bertahap, dengan setiap tahap berusaha memperbaiki kesalahan model sebelumnya melalui pendekatan gradient boosting.
Secara umum:
- Random Forest: cocok sebagai model awal yang kuat untuk berbagai dataset tabular dan relatif mudah digunakan.
- XGBoost: dapat memberikan performa sangat kompetitif pada data tabular, tetapi memerlukan perhatian pada pengaturan parameter dan proses pelatihan.
Anda juga dapat membaca Apa Itu XGBoost? Pengertian, Cara Kerja, dan Contoh Penerapannya
Keduanya tidak memiliki pemenang universal. Performa terbaik perlu ditentukan melalui evaluasi pada dataset dan skenario yang sama.
Kesimpulan
Random Forest adalah algoritma Machine Learning yang menggabungkan banyak pohon keputusan untuk menghasilkan prediksi klasifikasi atau regresi. Algoritma ini memanfaatkan variasi sampel data dan pemilihan fitur secara acak, kemudian menggabungkan prediksi pohon-pohon yang terbentuk.
Random Forest banyak digunakan dalam analisis sentimen, deteksi penipuan, prediksi harga, dan berbagai penelitian berbasis data. Kelebihannya mencakup kemampuan mempelajari pola kompleks dan menyediakan informasi pentingnya fitur, sedangkan keterbatasannya antara lain kebutuhan komputasi dan interpretasi model yang lebih sulit.
Bagi mahasiswa dan developer yang ingin mempelajari Machine Learning, Random Forest merupakan salah satu algoritma yang layak dicoba setelah memahami konsep dasar klasifikasi, regresi, dan evaluasi model.
Dengan menggunakan dataset yang sesuai dan mengevaluasi hasil secara benar, kamu dapat menentukan apakah Random Forest merupakan metode yang tepat untuk penelitian atau aplikasi yang sedang dikembangkan.
Ingin Mencoba Metode Random Forest dalam Program?
Bagi Anda yang ingin mempelajari penerapan Random Forest secara langsung, Anda juga bisa melihat Aplikasi Machine Learning Random Forest Klasifikasi untuk mencoba proses klasifikasi data melalui aplikasi berbasis web.
Lihat Source Code Random ForestSumber Referensi
Artikel ini disusun dengan mengacu pada dokumentasi resmi Scikit-learn mengenai Random Forest dan metode ensemble learning, yang menjelaskan konsep pembentukan pohon keputusan, bootstrap sampling, pemilihan fitur secara acak, serta penggabungan hasil prediksi. Referensi tambahan berasal dari penelitian Leo Breiman berjudul Random Forests, yang diterbitkan dalam jurnal Machine Learning pada tahun 2001 dan menjadi salah satu landasan penting pengembangan algoritma Random Forest.