XGBoost merupakan salah satu algoritma Machine Learning yang sering digunakan untuk klasifikasi data. Namun, bagaimana sebenarnya proses perhitungan XGBoost hingga menghasilkan prediksi?
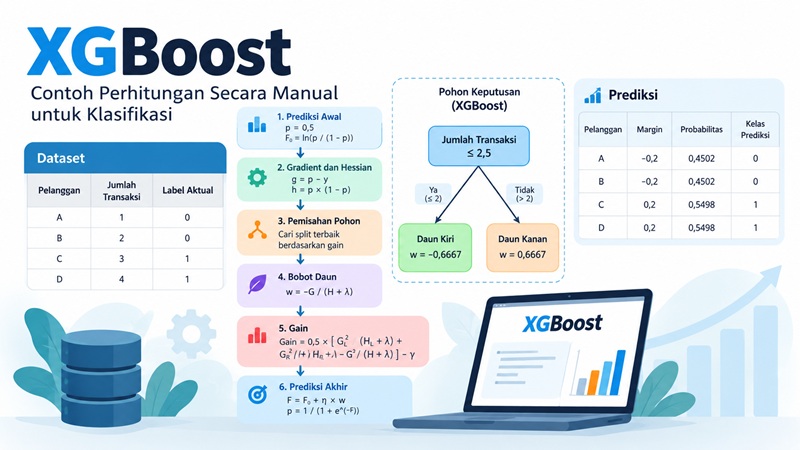
Pada artikel ini, kita akan membahas contoh perhitungan XGBoost secara manual menggunakan dataset sederhana. Pembahasan dimulai dari menghitung gradien dan hessian, menentukan bobot daun, menghitung gain, hingga menghasilkan prediksi.
Contoh ini cocok untuk mahasiswa yang sedang mempelajari Machine Learning atau mengerjakan skripsi dengan algoritma XGBoost.
1. Menyiapkan Dataset
Misalnya, kita ingin membuat model untuk memprediksi apakah seorang pelanggan akan membeli produk berdasarkan jumlah transaksi yang pernah dilakukan.
Kita menggunakan empat data sederhana berikut.
| Pelanggan | Jumlah Transaksi | Label Aktual |
|---|---|---|
| A | 1 | 0 |
| B | 2 | 0 |
| C | 3 | 1 |
| D | 4 | 1 |
Keterangan:
- Label 0 berarti pelanggan tidak membeli.
- Label 1 berarti pelanggan membeli.
Dataset tersebut hanya digunakan untuk ilustrasi perhitungan, bukan untuk menggambarkan pola pelanggan secara umum.
Dalam contoh ini, kita menggunakan klasifikasi biner dengan fungsi objektif logistik. Agar perhitungan lebih sederhana, model awal ditetapkan memiliki probabilitas prediksi sebesar 0,5 untuk setiap pelanggan.
2. Menentukan Prediksi Awal
Sebelum membangun pohon keputusan pertama, kita menentukan prediksi awal atau base score.
Misalnya, probabilitas awal setiap pelanggan adalah:
p = 0,5
Probabilitas tersebut dapat dikonversi menjadi nilai log-odds atau margin awal menggunakan rumus:
F₀ = ln(p / (1 - p))
Masukkan nilai probabilitas awal:
F₀ = ln(0,5 / (1 - 0,5))
F₀ = ln(0,5 / 0,5)
F₀ = ln(1) = 0
Jadi, margin awal model adalah 0. Nilai ini setara dengan probabilitas 0,5 pada fungsi sigmoid.
Perlu diperhatikan bahwa ini merupakan asumsi awal untuk mempermudah ilustrasi. Pada implementasi nyata, nilai awal model dapat ditentukan berdasarkan konfigurasi dan distribusi label pada data.
3. Menghitung Gradien dan Hessian
Tahap berikutnya adalah menghitung gradien dan hessian untuk setiap data.
Gradien menunjukkan arah perbaikan prediksi, sedangkan hessian menunjukkan kelengkungan fungsi objektif yang digunakan dalam proses optimasi.
Untuk klasifikasi biner dengan fungsi objektif logistik, rumusnya adalah:
Gradien:
g = p - y
Hessian:
h = p × (1 - p)
Keterangan:
- p adalah probabilitas prediksi model.
- y adalah label aktual.
- g adalah nilai gradien.
- h adalah nilai hessian.
Karena seluruh probabilitas awal bernilai 0,5, hessian setiap data adalah:
h = 0,5 × (1 - 0,5)
h = 0,5 × 0,5
h = 0,25
Sementara itu, gradien dihitung berdasarkan label aktual.
| Pelanggan | Label (y) | Prediksi (p) | Gradien (g) | Hessian (h) |
|---|---|---|---|---|
| A | 0 | 0,5 | 0,5 | 0,25 |
| B | 0 | 0,5 | 0,5 | 0,25 |
| C | 1 | 0,5 | -0,5 | 0,25 |
| D | 1 | 0,5 | -0,5 | 0,25 |
Data dengan label 0 menghasilkan gradien positif, sedangkan data dengan label 1 menghasilkan gradien negatif. Nilai-nilai tersebut digunakan untuk menentukan arah pembaruan model.
4. Menentukan Pemisahan Pohon Keputusan
XGBoost menggunakan pohon keputusan untuk mempelajari pola data. Salah satu tahap penting adalah menentukan pemisahan atau split yang memberikan perbaikan terbaik.
Dalam contoh ini, kita mencoba memisahkan pelanggan berdasarkan jumlah transaksi.
Misalnya, pemisahan dilakukan pada nilai 2,5:
- Cabang kiri: jumlah transaksi kurang dari atau sama dengan 2.
- Cabang kanan: jumlah transaksi lebih dari 2.
Hasil pemisahannya adalah:
| Cabang | Data | Total Gradien (G) | Total Hessian (H) |
|---|---|---|---|
| Kiri | A dan B | 1,0 | 0,5 |
| Kanan | C dan D | -1,0 | 0,5 |
Sebagai pembanding, total gradien seluruh data adalah:
G = 0,5 + 0,5 - 0,5 - 0,5
G = 0
Total hessian seluruh data adalah:
H = 0,25 + 0,25 + 0,25 + 0,25
H = 1
Nilai G dan H inilah yang digunakan dalam perhitungan bobot daun dan gain.
5. Menghitung Bobot Daun (Leaf Weight)
Setelah menentukan pemisahan, kita menghitung bobot untuk masing-masing daun pohon.
Rumus bobot optimal daun pada XGBoost adalah:
w = -G / (H + lambda)
Keterangan:
- w adalah bobot daun.
- G adalah total gradien pada daun.
- H adalah total hessian pada daun.
- lambda adalah parameter regularisasi untuk mengendalikan kompleksitas model.
Untuk contoh ini, kita menggunakan lambda = 1.
Menghitung bobot daun kiri
Diketahui:
G kiri = 1
H kiri = 0,5
Masukkan nilai tersebut ke rumus:
w kiri = -1 / (0,5 + 1)
w kiri = -1 / 1,5
w kiri = -0,6667
Jadi, bobot daun kiri adalah sekitar -0,6667.
Menghitung bobot daun kanan
Diketahui:
G kanan = -1
H kanan = 0,5
Masukkan nilai tersebut ke rumus:
w kanan = -(-1) / (0,5 + 1)
w kanan = 1 / 1,5
w kanan = 0,6667
Jadi, bobot daun kanan adalah sekitar 0,6667.
Nilai negatif menurunkan margin prediksi, sedangkan nilai positif menaikkan margin prediksi.
6. Menghitung Gain
Gain digunakan untuk menilai seberapa besar manfaat suatu pemisahan data dalam membentuk pohon keputusan.
Rumus gain untuk sebuah pemisahan adalah:
Gain = 0,5 × [Gk² / (Hk + lambda) + Gn² / (Hn + lambda) - G² / (H + lambda)] - gamma
Keterangan:
- Gk adalah total gradien cabang kiri.
- Gn adalah total gradien cabang kanan.
- Hk adalah total hessian cabang kiri.
- Hn adalah total hessian cabang kanan.
- G adalah total gradien sebelum pemisahan.
- H adalah total hessian sebelum pemisahan.
- lambda adalah parameter regularisasi.
- gamma adalah penalti untuk penambahan daun.
Kita menggunakan lambda = 1 dan gamma = 0.
Dari perhitungan sebelumnya, diketahui:
Gk = 1
Gn = -1
Hk = 0,5
Hn = 0,5
G = 0
H = 1
Masukkan nilai-nilai tersebut ke dalam rumus:
Gain = 0,5 × [1² / (0,5 + 1) + (-1)² / (0,5 + 1) - 0² / (1 + 1)] - 0
Hitung setiap bagian:
Gain = 0,5 × [1 / 1,5 + 1 / 1,5 - 0]
Gain = 0,5 × [0,6667 + 0,6667]
Gain = 0,5 × 1,3333
Gain = 0,6667
Hasil gain positif menunjukkan bahwa pemisahan tersebut memberikan perbaikan terhadap objektif model dibandingkan tidak melakukan pemisahan, berdasarkan asumsi dan parameter contoh ini.
Dalam praktiknya, XGBoost membandingkan berbagai kandidat pemisahan dan mempertimbangkan parameter seperti gamma serta batas kedalaman pohon sebelum menentukan struktur pohon yang digunakan.
7. Menghitung Prediksi Setelah Pohon Pertama
Setelah memperoleh bobot daun, kita memperbarui margin prediksi.
Untuk ilustrasi ini, kita menggunakan learning rate sebesar 0,3.
Learning rate = 0,3
Rumus pembaruan margin adalah:
F baru = F awal + learning rate × w
Karena margin awal bernilai 0, kita memperoleh hasil berikut.
Pelanggan A dan B
F baru = 0 + 0,3 × (-0,6667)
F baru = -0,2
Pelanggan C dan D
F baru = 0 + 0,3 × 0,6667
F baru = 0,2
Margin tersebut kemudian dikonversi menjadi probabilitas menggunakan fungsi sigmoid.
Rumus sigmoid:
p = 1 / (1 + e^(-F))
Untuk margin -0,2:
p = 1 / (1 + e^(0,2))
p = 0,4502
Jadi, probabilitas kelas 1 untuk pelanggan A dan B adalah sekitar 45,02%.
Untuk margin 0,2:
p = 1 / (1 + e^(-0,2))
p = 0,5498
Jadi, probabilitas kelas 1 untuk pelanggan C dan D adalah sekitar 54,98%.
Hasilnya dapat dirangkum sebagai berikut.
| Pelanggan | Label Aktual | Margin Baru | Probabilitas Prediksi |
|---|---|---|---|
| A | 0 | -0,2 | 0,4502 |
| B | 0 | -0,2 | 0,4502 |
| C | 1 | 0,2 | 0,5498 |
| D | 1 | 0,2 | 0,5498 |
Jika kita menggunakan ambang klasifikasi 0,5, pelanggan A dan B diprediksi masuk kelas 0, sedangkan pelanggan C dan D masuk kelas 1.
Pada contoh sederhana ini, prediksi setelah satu pohon sudah sesuai dengan label yang diberikan. Namun, probabilitasnya masih relatif dekat dengan 0,5.
Dalam proses XGBoost sebenarnya, pohon-pohon berikutnya dapat ditambahkan untuk memperbaiki prediksi berdasarkan gradien dan hessian terbaru, selama proses pelatihan dan kriteria penghentiannya mengizinkan.
8. Kesimpulan Perhitungan XGBoost
Dari contoh di atas, kita dapat memahami bahwa XGBoost tidak sekadar membuat pohon keputusan, tetapi juga menggunakan optimasi matematis untuk menentukan bobot daun dan mengevaluasi kualitas pemisahan.
Secara ringkas, tahapan perhitungannya meliputi:
- Menentukan prediksi awal.
- Menghitung gradien dan hessian.
- Menghitung total gradien dan hessian pada setiap kandidat cabang.
- Menghitung bobot daun.
- Menghitung gain untuk mengevaluasi pemisahan.
- Memperbarui margin dan menghitung probabilitas prediksi.
Contoh ini menggunakan empat data, satu pemisahan, dan satu pohon untuk mempermudah pembelajaran. Implementasi XGBoost pada dataset nyata dapat melibatkan banyak pohon, berbagai parameter, serta proses evaluasi yang lebih lengkap.
Bagi mahasiswa yang ingin menerapkan XGBoost dalam skripsi atau tugas akhir, penting untuk memahami dasar perhitungannya sekaligus menguji model dengan dataset yang relevan dan metrik evaluasi yang sesuai.
Ingin Mencoba Metode XGBoost dalam Program?
Bagi Anda yang ingin mempelajari penerapan XGBoost secara langsung, Anda juga bisa melihat Aplikasi Machine Learning XGBoost untuk mencoba proses klasifikasi data melalui aplikasi berbasis web.
Lihat Source Code XGBoostReferensi
Chen, T., & Guestrin, C. (2016). XGBoost: A Scalable Tree Boosting System. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 785–794.
DOI: https://doi.org/10.1145/2939672.2939785
Dokumentasi resmi XGBoost: https://xgboost.readthedocs.io/en/stable/