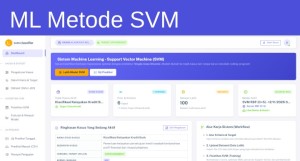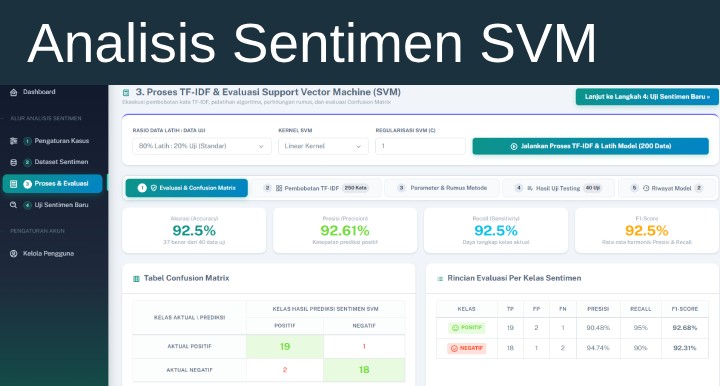
Aplikasi Analisis Sentimen Metode Support Vector Machine (SVM) merupakan aplikasi berbasis web yang dibangun menggunakan PHP Native dan MySQL untuk mengolah serta mengklasifikasikan data teks berdasarkan kategori sentimen. Aplikasi ini ditujukan bagi mahasiswa Teknik Informatika, Sistem Informasi, peneliti, maupun developer yang ingin mempelajari dan mengimplementasikan algoritma Support Vector Machine dalam penelitian atau pengembangan sistem analisis sentimen.
Aplikasi ini dirancang untuk melakukan analisis sentimen terhadap berbagai sumber data teks, seperti ulasan pengguna aplikasi, review pelanggan, komentar media sosial, maupun opini masyarakat. Menggunakan pendekatan Text Preprocessing, TF-IDF, dan Support Vector Machine, sistem dapat mengolah data komentar, membentuk model klasifikasi, serta menentukan kategori sentimen berdasarkan fungsi keputusan (Decision Function) SVM.
Dilengkapi fitur pengelolaan dataset, normalisasi bahasa, pembobotan kata, konfigurasi kernel, evaluasi model, hingga pengujian sentimen baru, aplikasi ini dapat menjadi referensi untuk penelitian, Skripsi, Tugas Akhir, maupun pengembangan sistem analisis opini berbasis web.
Kenapa Memilih Source Code Analisis Sentimen SVM Ini?
- 100% Pure PHP Native dan MySQL: Seluruh proses pengolahan teks, pembobotan TF-IDF, pelatihan model SVM, dan prediksi diimplementasikan menggunakan PHP Native tanpa memerlukan Python, Anaconda, Flask, maupun library machine learning eksternal. Aplikasi dapat dijalankan pada lingkungan XAMPP maupun Shared Hosting yang memenuhi persyaratan sistem.
- Multi-Kasus Dinamis Tanpa Mengubah Coding: Memungkinkan pengguna mengganti judul penelitian, objek atau sumber ulasan, skema kelas sentimen, serta dataset melalui antarmuka aplikasi. Tampilan halaman, grafik, dan tabel perhitungan menyesuaikan studi kasus yang digunakan.
- Mendukung Klasifikasi Biner dan Multi-Kelas: Mendukung klasifikasi 2 kelas (Positif dan Negatif) maupun 3 kelas (Positif, Netral, dan Negatif) menggunakan pendekatan One-vs-Rest (OvR) untuk klasifikasi multi-kelas.
- Text Preprocessing Bahasa Indonesia: Menyediakan tahapan pengolahan teks mulai dari Case Folding, Text Cleaning, Normalisasi Kata Slang, Stopword Removal dengan penanganan negasi, hingga Stemming menggunakan algoritma Nazief-Adriani.
- Dua Pilihan Kernel SVM: Mendukung Linear Kernel dan RBF (Gaussian) Kernel, dilengkapi pengaturan parameter regularisasi (C) untuk kebutuhan eksperimen dan pengujian model.
- Transparansi Perhitungan TF-IDF dan Hyperplane: Menampilkan frekuensi kata (TF), Document Frequency (DF), IDF, matriks TF-IDF dengan normalisasi L2, bobot hyperplane, nilai bias, serta fungsi keputusan SVM. Fitur ini membantu memahami proses matematis dan menyusun pembahasan hasil penelitian pada Bab 3 dan Bab 4 Skripsi.
- Auto-Labeling Berbasis Lexicon Indonesia: Menyediakan fitur pelabelan sentimen otomatis menggunakan kamus Lexicon Indonesia (InSet) berdasarkan skor kata positif dan negatif.
- Evaluasi dan Riwayat Eksperimen: Menampilkan Accuracy, Precision, Recall, F1-Score, Confusion Matrix, serta riwayat eksperimen model untuk membantu membandingkan hasil pengujian.
Fitur-Fitur Utama Aplikasi
1. Dashboard dan Pengaturan Studi Kasus
-
- Dashboard Visual: Menampilkan identitas studi kasus aktif, ringkasan jumlah dataset, akurasi model SVM, grafik proporsi kelas sentimen, serta panduan alur penggunaan aplikasi.
- Pengaturan Kasus: Mengelola judul penelitian, objek atau sumber ulasan, deskripsi penelitian, dan skema klasifikasi sentimen.
- Pilihan Skema Sentimen: Mendukung konfigurasi klasifikasi 2 kelas maupun 3 kelas.
- Reset Studi Kasus: Memulai penelitian atau studi kasus baru menggunakan pengaturan yang tersedia pada aplikasi.
2. Manajemen Dataset dan Text Preprocessing
-
- Manajemen Komentar: Menambahkan, mengubah, dan menghapus data komentar beserta label sentimennya secara manual.
- Import Dataset CSV: Mengunggah dataset komentar dengan kemampuan mendeteksi kolom komentar dan label secara otomatis.
- Auto-Labeling Lexicon: Memberikan label sentimen berdasarkan kamus Lexicon Indonesia (InSet) melalui proses otomatis.
- Text Preprocessing Step-by-Step: Menampilkan perubahan teks komentar pada setiap tahapan pengolahan dalam bentuk tabel, meliputi:
- Case Folding dan Text Cleaning untuk menyeragamkan teks serta menghapus URL, mention, angka, simbol, tanda baca, dan emoji.
- Normalisasi Kata Slang untuk mengubah kata tidak baku menjadi kata yang telah ditentukan dalam kamus normalisasi.
- Stopword Removal untuk menghapus kata umum yang tidak diperlukan, dengan penanganan khusus terhadap kata negasi seperti tidak dan kurang.
- Stemming Bahasa Indonesia menggunakan algoritma Nazief-Adriani untuk mengubah kata berimbuhan menjadi kata dasar.
- Kamus Bahasa Indonesia: Mengelola daftar kata slang dan normalisasi, stopword, serta kamus Lexicon positif dan negatif.
3. Proses Pelatihan dan Evaluasi SVM
-
- Pengaturan Data Latih dan Data Uji: Mendukung pilihan rasio pembagian dataset 90:10, 80:20, 75:25, dan 70:30.
- Pilihan Fungsi Kernel: Menyediakan Linear Kernel dan RBF (Gaussian) Kernel untuk kebutuhan eksperimen klasifikasi.
- Pengaturan Hyperparameter: Mengatur parameter regularisasi (C) untuk menentukan keseimbangan antara margin hyperplane dan penalti kesalahan klasifikasi.
- Pelatihan Model SVM: Mengimplementasikan proses optimasi Sequential Minimal Optimization (SMO) untuk membentuk model klasifikasi.
- Evaluasi Performa Model: Menampilkan Accuracy, Precision, Recall, F1-Score, dan Confusion Matrix.
- Perhitungan TF-IDF: Menampilkan tabel frekuensi kata (TF), Document Frequency (DF), bobot IDF, dan matriks TF-IDF dengan normalisasi L2.
- Detail Hyperplane SVM: Menampilkan nilai bias (b), jumlah Support Vectors, serta daftar kata dengan bobot positif dan negatif tertinggi untuk kernel Linear.
- Detail Data Testing: Menampilkan hasil perbandingan kelas aktual dan kelas prediksi SVM pada setiap data pengujian.
- Riwayat Eksperimen: Menyimpan dan menampilkan riwayat pengujian model untuk membantu membandingkan hasil eksperimen.
4. Uji Sentimen Baru
-
- Uji Kalimat Tunggal: Memasukkan satu kalimat ulasan untuk memperoleh hasil klasifikasi sentimen secara langsung.
- Contoh Kalimat Cepat: Menyediakan contoh kalimat untuk mempermudah proses pengujian.
- Detail Preprocessing: Menampilkan tahapan pengolahan teks dari kalimat asli hingga hasil akhir preprocessing.
- Detail Perhitungan SVM: Menampilkan kontribusi bobot setiap kata terhadap nilai keputusan, termasuk perhitungan wᵢ × TF-IDFᵢ dan nilai fungsi keputusan f(x).
- Uji Sentimen Massal (Batch CSV): Mengunggah file CSV berisi banyak komentar untuk diprediksi secara sekaligus.
- Riwayat Pengujian: Menyimpan arsip hasil pengujian kalimat baru.
5. Manajemen Pengguna
-
- Multi-Level User: Mendukung dua tingkatan hak akses, yaitu Administrator dan Operator.
- Pengelolaan Akun: Mengatur pengguna sesuai hak akses yang tersedia.
- Ubah Password: Menyediakan fitur perubahan password untuk pengguna aplikasi.
Contoh Topik Skripsi yang Bisa Menggunakan Aplikasi Ini
Aplikasi Analisis Sentimen SVM dapat dikembangkan untuk berbagai kebutuhan penelitian, di antaranya:
- Analisis Sentimen Ulasan Pengguna Aplikasi Layanan Publik atau Mobile Banking di Google Play Store Menggunakan Metode Support Vector Machine (SVM) dan TF-IDF.
- Klasifikasi Sentimen Review Pelanggan E-Commerce (Shopee, Tokopedia, atau Lazada) Menggunakan Algoritma Support Vector Machine.
- Analisis Sentimen Opini Masyarakat di Media Sosial X (Twitter) dan TikTok Menggunakan Metode Support Vector Machine Berbasis Lexicon.
- Implementasi Metode Support Vector Machine dan Pembobotan TF-IDF untuk Analisis Kepuasan Layanan Akademik Mahasiswa.
- Klasifikasi Sentimen Ulasan Pengunjung Objek Wisata atau Perhotelan Berdasarkan Google Reviews Menggunakan Algoritma SVM.
Topik penelitian dapat disesuaikan dengan objek penelitian, sumber data, dataset, serta skema kelas sentimen yang digunakan.
Spesifikasi Teknologi dan Kebutuhan Sistem
- Bahasa Pemrograman: PHP Native berbasis OOP, mendukung PHP 7.4 hingga 8.3.
- Database: MySQL / MariaDB.
- Desain Antarmuka: Bootstrap 5 Modern Responsive.
- Tampilan Admin: Dark Slate-Teal Sidebar.
- Web Server Lokal: XAMPP atau lingkungan server PHP yang kompatibel.
- Hosting: Shared Hosting cPanel yang memenuhi persyaratan sistem aplikasi.
Apa Saja yang Didapatkan dalam Paket Pembelian?
- Full Source Code Aplikasi (Sentimen_SVM): Source code aplikasi analisis sentimen yang dapat dipelajari, digunakan, dan dimodifikasi sesuai kebutuhan penelitian.
- Database MySQL (adev_sc_ml_sentimen_svm.sql): File database lengkap dengan struktur tabel, kamus Bahasa Indonesia, dan dataset awal.
- File Excel Perhitungan Manual (Perhitungan_Metode_Sentimen_SVM.xlsx): Dilengkapi formula Excel aktif untuk membantu perhitungan TF-IDF, normalisasi vektor L2, bobot hyperplane (wᵢ), dot product menggunakan SUMPRODUCT, nilai keputusan f(x), hingga penentuan kelas berdasarkan fungsi sign(f(x)). Sangat membantu dalam memahami perhitungan untuk Bab 3 dan Bab 4 Skripsi.
- Empat Dataset CSV Siap Pakai: Terdiri dari dataset ulasan Play Store, review E-Commerce, opini media sosial 3 kelas, dan komentar mentah tanpa label.
- Panduan Instalasi dan Penggunaan: File petunjuk instalasi mulai dari konfigurasi XAMPP, import database, penggunaan menu aplikasi, hingga proses analisis sentimen.
Cocok untuk Siapa?
Source code ini dapat dimanfaatkan oleh:
- Mahasiswa Teknik Informatika dan Sistem Informasi yang mengerjakan Skripsi atau Tugas Akhir.
- Peneliti yang mempelajari analisis sentimen, Text Mining, dan Natural Language Processing.
- Developer yang ingin mengembangkan aplikasi klasifikasi teks berbasis PHP dan MySQL.
- Pengguna yang ingin mempelajari penerapan algoritma Support Vector Machine pada aplikasi web.
Aplikasi ini dapat digunakan sebagai dasar pengembangan berbagai sistem klasifikasi sentimen, seperti analisis ulasan aplikasi, review produk, opini masyarakat, kepuasan layanan akademik, dan berbagai permasalahan klasifikasi teks lainnya.