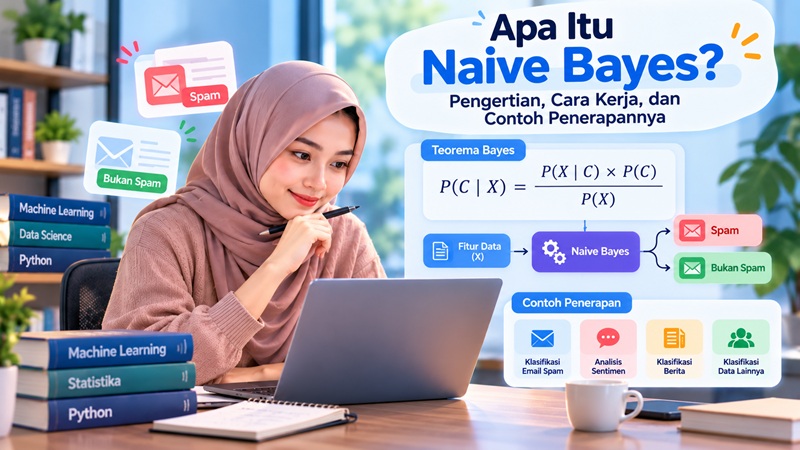
Dalam machine learning, terdapat berbagai algoritma yang dapat digunakan untuk mengelompokkan data dan membuat prediksi. Salah satu algoritma yang cukup populer karena sederhana dan relatif cepat adalah Naive Bayes.
Metode ini dapat digunakan untuk mengklasifikasikan email spam, menganalisis sentimen pelanggan, mengelompokkan berita, hingga membantu proses klasifikasi dalam penelitian mahasiswa.
Menariknya, Naive Bayes menggunakan konsep probabilitas yang sebenarnya sering kita temui dalam kehidupan sehari-hari. Algoritma ini memperkirakan kemungkinan suatu data masuk ke dalam kategori tertentu berdasarkan pola yang dipelajari dari data sebelumnya.
Lalu, apa itu Naive Bayes, bagaimana cara kerjanya, dan kapan metode ini cocok digunakan? Mari kita bahas secara bertahap.
1. Pengertian Naive Bayes
Naive Bayes adalah algoritma machine learning untuk klasifikasi yang menggunakan Teorema Bayes berdasarkan perhitungan probabilitas. Algoritma ini mempelajari hubungan antara karakteristik data dan kelasnya, kemudian memperkirakan kelas yang paling mungkin untuk data baru.
Naive Bayes termasuk metode supervised learning, yaitu pembelajaran mesin yang menggunakan data latih yang sudah memiliki label atau kategori.
Sebagai contoh, kita ingin membuat sistem untuk mengklasifikasikan email menjadi dua kategori:
- Spam: email yang tidak diinginkan, seperti pesan promosi mencurigakan.
- Bukan spam: email yang dianggap normal atau relevan.
Sistem diberikan sejumlah email yang sudah diberi label. Dari data tersebut, algoritma mempelajari pola kata atau karakteristik yang sering muncul pada setiap kategori.
Ketika menerima email baru, sistem menghitung kemungkinan email tersebut termasuk spam atau bukan spam, lalu memilih kategori dengan nilai probabilitas yang lebih tinggi.
Itulah gambaran sederhana cara kerja Naive Bayes.
2. Mengapa Disebut Naive Bayes?
Nama Naive Bayes terdiri dari dua bagian, yaitu Naive dan Bayes. Naive berarti sederhana atau mengasumsikan bahwa setiap fitur bersifat saling independen secara kondisional ketika kelasnya diketahui. Dengan kata lain, algoritma memperlakukan setiap fitur seolah-olah dapat dihitung kontribusinya secara terpisah setelah kategori diperhitungkan.
Dalam praktiknya, fitur-fitur pada data nyata belum tentu benar-benar independen. Misalnya, kata “diskon” dan “promo” mungkin sering muncul bersama dalam email.
Bayes merujuk pada Teorema Bayes, yaitu aturan matematika untuk memperbarui probabilitas suatu kejadian berdasarkan informasi yang tersedia.
Kombinasi keduanya membuat Naive Bayes relatif sederhana untuk diterapkan, terutama pada permasalahan klasifikasi teks dan data yang memiliki banyak fitur.
3. Rumus Naive Bayes dan Penjelasannya
Naive Bayes menggunakan Teorema Bayes untuk menghitung probabilitas suatu kelas berdasarkan fitur yang dimiliki data. Rumus dasarnya adalah:
Keterangan:
- P(C | X): probabilitas data X termasuk kelas C setelah karakteristiknya diketahui.
- P(X | C): probabilitas karakteristik X muncul pada kelas C.
- P(C): probabilitas awal kelas C, sebelum karakteristik data diperhitungkan.
- P(X): probabilitas karakteristik data X secara keseluruhan.
Dalam klasifikasi dengan beberapa fitur, asumsi independensi Naive Bayes memungkinkan perhitungan disederhanakan menjadi:
Rumus tersebut berarti algoritma menggabungkan probabilitas awal suatu kelas dengan probabilitas setiap fitur pada kelas tersebut.
Dalam proses klasifikasi, nilai untuk setiap kelas dibandingkan. Kelas dengan nilai probabilitas posterior terbesar dipilih sebagai hasil prediksi. Untuk membandingkan kelas, faktor (P(X)) dapat diabaikan karena nilainya sama untuk semua kelas pada data yang sedang diprediksi.
Jangan khawatir jika rumus ini terlihat rumit. Intinya, Naive Bayes menggunakan informasi dari data sebelumnya untuk memperkirakan kategori yang paling mungkin.
4. Bagaimana Cara Kerja Algoritma Naive Bayes?
Secara umum, proses kerja Naive Bayes dapat dibagi menjadi beberapa tahap.
1. Menyiapkan dataset
Langkah pertama adalah menyiapkan data yang sudah memiliki label kelas. Misalnya, kita memiliki dataset ulasan pelanggan yang dibagi menjadi sentimen positif dan negatif. Setiap ulasan menjadi satu baris data, sedangkan label sentimen menjadi target klasifikasi.
2. Menghitung probabilitas awal setiap kelas
Algoritma menghitung proporsi masing-masing kelas dalam data latih. Sebagai contoh, jika dari 100 ulasan terdapat 60 ulasan positif dan 40 ulasan negatif, probabilitas awalnya adalah:
- Positif: 60/100 = 0,6.
- Negatif: 40/100 = 0,4.
Nilai ini disebut prior probability.
3. Menghitung probabilitas setiap fitur
Berikutnya, algoritma menghitung seberapa sering fitur tertentu muncul pada masing-masing kelas. Pada klasifikasi teks, misalnya, sistem dapat mempelajari seberapa sering kata “bagus” muncul pada ulasan positif dan negatif.
Probabilitas fitur tersebut kemudian digunakan bersama probabilitas awal kelas untuk menghitung kemungkinan kelas bagi data baru.
4. Menghitung probabilitas kelas data baru
Ketika menerima ulasan baru, sistem menghitung nilai probabilitas untuk setiap kelas berdasarkan fitur yang ditemukan. Jika ulasan tersebut memiliki beberapa kata, kontribusi probabilitas kata-kata itu digabungkan sesuai dengan asumsi Naive Bayes.
5. Menentukan hasil klasifikasi
Terakhir, sistem membandingkan nilai yang diperoleh dari setiap kelas dan memilih kelas dengan nilai posterior terbesar. Misalnya, hasil perhitungan menunjukkan bahwa ulasan baru lebih mungkin termasuk sentimen positif daripada negatif. Sistem pun memberikan prediksi positif.
Tahapan ini merupakan gambaran umum. Cara menghitung probabilitas fitur secara terperinci bergantung pada jenis Naive Bayes yang digunakan dan karakteristik dataset.
5. Jenis-Jenis Naive Bayes
Naive Bayes memiliki beberapa varian. Pemilihan jenisnya perlu disesuaikan dengan bentuk dan distribusi data yang digunakan.
Gaussian Naive Bayes
Gaussian Naive Bayes cocok digunakan ketika fitur berbentuk numerik kontinu dan dimodelkan mengikuti distribusi normal atau Gaussian untuk setiap kelas.
Contohnya adalah klasifikasi berdasarkan tinggi badan, berat badan, atau hasil pengukuran numerik lainnya, selama asumsi distribusinya cukup sesuai.
Multinomial Naive Bayes
Multinomial Naive Bayes sering digunakan dalam klasifikasi teks dengan fitur berupa jumlah kemunculan kata atau representasi numerik seperti TF-IDF.
Contoh penerapannya adalah klasifikasi berita, pengelompokan dokumen, dan penyaringan email spam.
Bernoulli Naive Bayes
Bernoulli Naive Bayes cocok untuk fitur biner, misalnya apakah suatu kata muncul atau tidak dalam sebuah dokumen.
Sebagai contoh, fitur “mengandung kata diskon” dapat diberi nilai 1 jika kata tersebut muncul dan 0 jika tidak muncul.
Categorical Naive Bayes
Categorical Naive Bayes digunakan untuk fitur kategorikal, seperti jenis pekerjaan, tingkat pendidikan, atau kategori penghasilan.
Contohnya adalah klasifikasi kelayakan berdasarkan atribut seperti pendidikan, status pekerjaan, dan kategori pendapatan.
Perlu diperhatikan bahwa nama fitur saja tidak otomatis menentukan varian yang tepat. Cara data direpresentasikan dan asumsi model juga perlu dipertimbangkan.
6. Contoh Penerapan Naive Bayes
Naive Bayes dapat digunakan dalam berbagai bidang. Berikut beberapa contoh penerapannya.
Klasifikasi email spam
Sistem mempelajari pola kata dan karakteristik email yang sebelumnya diberi label spam atau bukan spam. Email baru kemudian diklasifikasikan berdasarkan pola tersebut.
Analisis sentimen
Naive Bayes dapat digunakan untuk mengelompokkan ulasan pelanggan menjadi sentimen positif, negatif, atau kategori lain yang ditentukan dalam penelitian.
Contohnya adalah analisis ulasan produk di toko online atau komentar pengguna terhadap suatu layanan.
Klasifikasi berita
Artikel berita dapat diklasifikasikan ke dalam kategori seperti olahraga, teknologi, ekonomi, dan hiburan berdasarkan fitur teksnya.
Klasifikasi data mahasiswa
Dalam penelitian akademik, Naive Bayes dapat digunakan untuk mengklasifikasikan data mahasiswa berdasarkan target yang ditentukan, misalnya kategori kelulusan atau risiko keterlambatan studi.
Penggunaan seperti ini harus didasarkan pada data yang relevan dan evaluasi model yang memadai. Hasil klasifikasi juga tidak boleh dianggap sebagai kepastian mengenai kondisi seseorang.
Klasifikasi kelayakan
Naive Bayes dapat diterapkan untuk memperkirakan kategori kelayakan berdasarkan atribut tertentu. Namun, pada konteks yang berdampak besar, seperti kredit atau keputusan penting lainnya, hasil model perlu diperiksa secara hati-hati dan tidak sebaiknya menjadi satu-satunya dasar keputusan.
7. Kelebihan dan Kekurangan Naive Bayes
Sebelum menggunakan algoritma ini dalam proyek atau penelitian, penting untuk memahami kelebihan sekaligus keterbatasannya.
Kelebihan Naive Bayes
- Relatif mudah dipahami: konsep dasarnya menggunakan probabilitas dan perhitungan frekuensi.
- Proses pelatihan cepat: pada banyak kasus, model dapat dilatih dengan biaya komputasi yang rendah.
- Cocok untuk klasifikasi teks: terutama untuk tugas seperti klasifikasi dokumen dan penyaringan spam.
- Dapat bekerja dengan data berdimensi tinggi: misalnya teks yang direpresentasikan dengan banyak fitur kata.
- Membutuhkan data latih relatif sedikit pada sejumlah permasalahan: meskipun jumlah data yang diperlukan tetap bergantung pada kompleksitas masalah dan kualitas data.
Kekurangan Naive Bayes
- Asumsi independensi sering tidak sepenuhnya sesuai: hubungan antarfitur dapat memengaruhi hasil klasifikasi.
- Dapat mengalami probabilitas nol: fitur yang belum pernah muncul pada suatu kelas dapat membuat hasil perkalian probabilitas menjadi nol jika tidak ditangani. Teknik Laplace smoothing dapat membantu mengatasi masalah ini.
- Probabilitas prediksi belum tentu terkalibrasi dengan baik: nilai probabilitas yang dihasilkan tidak selalu mencerminkan tingkat keyakinan yang akurat.
- Tidak selalu menjadi metode dengan performa terbaik: hasilnya bergantung pada dataset, representasi fitur, dan tujuan klasifikasi.
Karena itu, Naive Bayes sebaiknya diuji menggunakan data pengujian yang sesuai dan dibandingkan dengan metode lain jika diperlukan.
8. Apakah Naive Bayes Cocok untuk Skripsi?
Ya, Naive Bayes dapat menjadi pilihan metode untuk skripsi atau tugas akhir, terutama jika penelitian berfokus pada klasifikasi data.
Beberapa contoh ide judul penelitian yang dapat dikembangkan adalah:
- Analisis Sentimen Ulasan Pengguna Aplikasi Menggunakan Metode Naive Bayes.
- Klasifikasi Berita Berbahasa Indonesia Menggunakan Multinomial Naive Bayes.
- Implementasi Naive Bayes untuk Klasifikasi Kepuasan Pelanggan.
- Perbandingan Naive Bayes dan Support Vector Machine untuk Analisis Sentimen.
- Klasifikasi Ulasan Produk Berdasarkan Sentimen Menggunakan Metode Naive Bayes.
Judul tersebut masih berupa ide awal. Sebelum menentukan judul, pastikan dataset tersedia, masalah penelitian jelas, dan metode yang dipilih sesuai dengan tujuan penelitian.
Untuk memperkuat penelitian, mahasiswa juga perlu menjelaskan proses prapemrosesan data, pembagian data latih dan data uji, pemilihan varian Naive Bayes, serta evaluasi model. Metrik seperti accuracy, precision, recall, dan F1-score dapat digunakan sesuai dengan karakteristik masalah.
9. Kesimpulan
Naive Bayes adalah algoritma machine learning untuk klasifikasi yang memanfaatkan Teorema Bayes dan asumsi independensi kondisional antarfitur. Algoritma ini relatif sederhana, cepat, dan banyak digunakan pada klasifikasi teks maupun berbagai permasalahan klasifikasi lainnya.
Untuk mendapatkan hasil yang baik, pemilihan varian Naive Bayes harus disesuaikan dengan karakteristik data. Model juga perlu dievaluasi menggunakan data pengujian agar performanya dapat dinilai secara objektif.
Jika ingin mempelajari algoritma ini lebih dalam, langkah berikutnya adalah memahami perhitungan probabilitasnya secara langsung.
Pada artikel selanjutnya, kita akan membahas contoh perhitungan Naive Bayes secara manual, mulai dari dataset sederhana, menghitung probabilitas setiap kelas, menghitung probabilitas fitur, hingga menentukan hasil klasifikasi.
Dengan mengikuti contoh tersebut, pembaca dapat memahami bagaimana Naive Bayes menghasilkan prediksi tanpa hanya mengandalkan rumus atau kode program.
Ingin Mencoba Metode Naive Bayes dalam Program?
Bagi Anda yang ingin mempelajari penerapan Naive Bayes secara langsung, Anda juga bisa melihat Aplikasi Machine Learning Naive Bayes untuk mencoba prosesnya melalui aplikasi berbasis web.
Aplikasi Naive Bayes CategoricalAplikasi Naive Bayes Gaussian